Contexto
Cada semestre, la Pontificia Universidad Católica de Chile tiene que armar los grupos de proyecto de dos cursos masivos: Desafíos de la Ingeniería y Sustentabilidad. Cada curso tiene cientos de alumnos y cada alumno tiene sus propias preferencias y restricciones: temas que le gustaría trabajar, horarios disponibles y atributos (género, universidad de origen, etc.) que conviene repartir equilibradamente entre los grupos.
Hacerlo a mano le tomaba varios días al equipo académico y, aun así, no se podía asegurar que la asignación fuera buena, en el sentido de que cada alumno quede asignado a un grupo con un tema de su preferencia. Por eso construimos MATE (Make A Team Efficiently): una aplicación en la que subes una planilla con los alumnos, dices cuántos grupos quieres y qué reglas se tienen que cumplir, y obtienes una asignación completa.
El desafío
Armar grupos parece fácil hasta que juntas todas las reglas: tamaño mínimo y máximo, cupos por horario, balance de atributos, topes por tema, y encima que a cada alumno le toque uno de los temas que pidió. Este tipo de problemas son resueltos generalmente a travès de un modelo de optimización entero mixto.
El problema es que esta famila de modelos de optimización suelen requerir de extensos tiempos de ejecución cuando se considera un conjunto relativamente grande de variables. Así que gran parte del trabajo fue hacer que el problema fuera más pequeño y más fácil de resolver, sin cambiar la respuesta. Trabajamos en tres frentes: un preprocesamiento que elimina simetrías, un warm start que le da al solver un punto de partida razonable y un postprocesamiento que construye la asignaciòn entregada al equipo académico, acompañado de insights de la solución.
MATE de punta a punta
Cada vez que alguien ejecuta una optimización en MATE ocurren cinco etapas. Las dos de los extremos (pre y postprocesamiento) son las que permiten que el modelo del centro sea resoluble y que el resultado sea útil para el equipo académico.
Preprocesamiento
Chequeamos que los parámetros ingresados sean factibles antes de formular el modelo. De ser factibles, agrupamos a los alumnos idénticos en "tipos" para reducir el tamaño del modelo.
Formulación del modelo MIP
Variables, restricciones y una función objetivo que premia dar a cada alumno sus primeras opciones.
Warm start
Una heurística rápida arma una asignación de partida para que el solver no empiece desde cero.
Resolución del modelo
El solver de Google OR-Tools busca el óptimo, o demuestra que con esas reglas no se puede y diagnostica qué reglas chocan.
Postprocesamiento
Mapeamos la solución del modelo a una asignación de estudiantes, generamos un Excel con los resultados y proveemos insights para hacer análisis de sensibilidad de la solución.
Conjuntos y parámetros
Antes de preprocesar y de escribir el modelo, estos son los conjuntos y los datos que usamos en todas las fórmulas de más abajo.
Conjuntos
Parámetros
1. Preprocesamiento
Antes de resolver, MATE hace dos cosas: comprueba que los parámetros no sean imposibles de cumplir y agrupa a los alumnos intercambiables en tipos. Lo primero evita resolver en vano, y lo segundo es la decisión que más pesa en el rendimiento.
a. Chequeo de parámetros
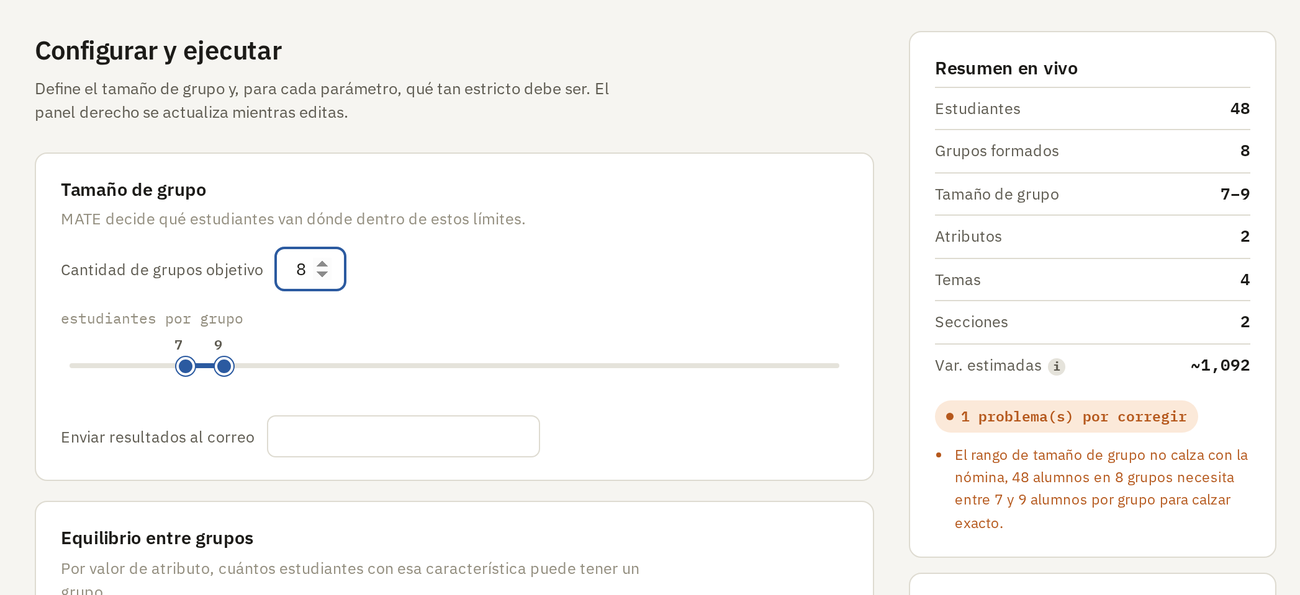
Hay combinaciones de parámetros que son imposibles sin necesidad de resolver nada. MATE las detecta en la propia pantalla de configuración, en tiempo real, mientras se ajustan los controles. Si alguna se cumple, no tiene sentido ejecutar el solver. Son condiciones suficientes de infactibilidad, deducidas directamente de las restricciones:
Alguien marcó que no puede en ningún horario.
Pides más grupos que los candidatos que se pueden construir.
Con todos los grupos en el tamaño máximo no cabe el curso, o con todos en el mínimo sobran grupos.
El total de alumnos con una característica no es compatible con el rango por grupo.
Los cupos de todos los horarios juntos no alcanzan para alojar a todo el curso.
Los topes por tema no alcanzan para formar la cantidad de grupos pedida (o los mínimos se pasan).
Así se ve en la app. Si pides, por ejemplo, 8 grupos de entre 7 y 9 alumnos para una nómina de 48, el panel en vivo marca el problema en rojo y el botón de ejecutar queda bloqueado.
b. Mapeo de alumnos a tipos de alumnos
El problema: Simetría de la asignación óptima
La formulación más directa del problema usaría una variable binaria \(x_{sg}\) por cada par (alumno, grupo), con \(s \in S\) y \(g \in G\): vale 1 si el alumno \(s\) queda en el grupo \(g\), y 0 si no. El problema es que esta formulación contiene muchas soluciones idénticas, es decir, tiene simetrías. Por ejemplo, imagina que tenemos 3 alumnas con los mismos atributos (todas mujeres, por ejemplo), la misma disponibilidad horaria y las mismas preferencias de tema. Para la asignación que hace el modelo es indiferente cuál de las 3 va a un grupo: son intercambiables. Si las 3 van a 3 grupos distintos, hay \(3! = 6\) maneras de repartirlas que obtienen la misma función objetivo.
La presencia de simetrías en la formulación afecta negativamente al branch and bound, el algoritmo con el que se resuelve el modelo MIP. El branch and bound va partiendo el problema en ramas y descartando las que no pueden mejorar la mejor solución conocida. Las copias equivalentes caen en ramas distintas y, como todas tienen el mismo valor y la misma cota, ninguna se puede descartar por ser peor que otra: el solver las recorre una por una. La relajación lineal también se resiente, porque tiende a repartir de forma fraccionaria a los alumnos idénticos y eso debilita la cota.
La solución: Asignar tipos de alumnos en lugar de alumnos
Para eliminar la simetría, agrupamos a los alumnos en tipos: dos alumnos son del mismo tipo si comparten atributos, orden de preferencias de tema y, cuando hay módulos configurados, disponibilidad horaria. En vez de una variable binaria por alumno, usamos una variable entera \(y_{ig}\) por tipo \(i \in I\) y grupo \(g \in G\), que cuenta cuántos alumnos del tipo \(i\) van al grupo \(g\). En el ejemplo, las 3 alumnas forman un solo tipo \(i \in I\) con \(R_i = 3\), y hay una sola manera de decir "3 alumnas de este tipo van a este grupo". Esas ramas repetidas desaparecen y el solver gasta su tiempo en soluciones realmente distintas. Todo el modelo de la sección siguiente se escribe en términos de \(y_{ig}\).
Además, esta formulación puede reducir drásticamente el número de variables: pasamos de \(|S| \times |G|\) a \(|I| \times |G|\). La baja depende de cuántos alumnos sean parecidos entre sí: en cursos con muchos alumnos parecidos es grande, y en el peor caso, cuando todos los alumnos son distintos, hay un tipo por alumno y la cantidad de variables queda igual. En la nómina de ejemplo, 48 alumnos se juntan en 25 tipos y las variables de asignación bajan de 1.408 a 688 (una reducción del 51%).
2. Formulación del modelo MIP
Cada corrida de MATE es un programa entero mixto (MIP): un modelo matemático con variables de decisión, restricciones y una función objetivo, escrito con los conjuntos y parámetros de la sección anterior. Antes de cada fórmula va la versión en castellano, así que si las fórmulas no son lo tuyo, igual puedes quedarte con la idea.
Variables de decisión
Restricciones
Algunas son hechos del problema (por ejemplo, un alumno solo puede ir a un horario en que está disponible) y otras son decisiones de política que el equipo académico mueve desde la pantalla de configuración.
Cada estudiante queda asignado a exactamente un grupo.
Un grupo solo puede recibir estudiantes si está activado.
Se activa exactamente la cantidad de grupos objetivo.
Cada grupo activo mantiene su tamaño entre el mínimo y el máximo.
Los grupos por tema se mantienen dentro del rango configurado.
Un tema cuenta como "usado" si se asigna en algún módulo, y se usan a lo más \(UP\) temas en total.
A lo más un alumno sin respuesta puede quedar en el mismo grupo sin penalización; los demás se cuentan y se penalizan en el objetivo.
Se registra la preferencia que obtiene cada tipo.
Se sigue la peor preferencia de todas, para poder penalizarla en el objetivo.
El conteo por característica se mantiene en rango, o es cero si se permite.
Un módulo no puede recibir más estudiantes que su capacidad.
Un grupo solo incluye estudiantes disponibles para ese módulo.
Si los temas deben quedar en un solo módulo, todos sus grupos lo comparten.
Un tema solo puede quedar en un módulo si no está excluido de él.
Función objetivo
MATE minimiza la suma de las preferencias obtenidas por todos los estudiantes, ponderada por la flexibilidad horaria de cada tipo (\(N_i\)), de modo que una primera opción siempre cuesta menos que una segunda. A eso le suma una constante de balance \(K\) que castiga tanto al estudiante peor ubicado como al grupo con más alumnos sin respuesta.
\(K\) es muy grande a propósito: debe ser un número al menos mayor que la cantidad total de alumnos \(\sum_{i \in I} R_i\), para que pese más que cualquier término de preferencia. En la práctica, primero se prioriza la equidad y el promedio queda como criterio de desempate. El solver no sacrifica a un tipo de alumno solo para mejorar levemente el promedio.
3. Warm start: heurística para obtener una solución inicial
Antes de que el solver empiece a buscar, una heurística simple construye una asignación de partida y se la pasa al solver como warm start. No tiene que ser buena ni siquiera factible: es solo un punto de partida razonable para la búsqueda, en lugar de empezar desde cero.
a. Pasada por las preferencias
Para cada tipo de alumno, en orden de ranking (primero la primera opción, después la segunda, etc.), asignamos a todos los que quepan a un grupo de ese tema, y si hay horarios, solo en uno donde el tipo está disponible. Es una regla simple de primer ajuste.
b. Pasada por los que sobraron
Quienes no alcanzaron lugar en ninguno de sus temas (porque los grupos se llenaron antes de que les llegara el turno) se asignan a cualquier grupo donde físicamente puedan estar, ignorando sus preferencias. Así el warm start queda como una asignación completa.
La heurística solo respeta lo estructural (disponibilidad horaria y capacidad del grupo) y se olvida del objetivo y del balance. Construirla tiene un costo mínimo, porque es código Python simple que no llama al solver. Esta heurística de warm start redujo el tiempo de ejecución en cerca de un 20% en promedio, al probarla con distintos parámetros y comparándola con el mismo modelo sin warm start.
4. Resolución del modelo
Con el modelo construido y el warm start listo, el solver busca la mejor asignación posible, o demuestra que con esas reglas no existe ninguna.
CP-SAT, de Google OR-Tools
Resolvemos el modelo con CP-SAT, el solver open source de Google OR-Tools. Para saber si alcanzaba para nuestro problema, medimos el tiempo de resolución contra la cantidad de variables en 14 puntos de prueba. Hasta unas 3.000 o 4.000 variables resuelve entre menos de un segundo y unos pocos segundos. Pasadas las 5.000 o 6.000, el tiempo crece mucho y se vuelve impredecible, así que fijamos en 4.000 variables el tamaño máximo de un modelo que MATE resuelve en línea.
La nómina de ejemplo de 48 alumnos genera unas 1.100 variables, muy por debajo de ese límite. Con nóminas sintéticas de 400 alumnos, el tiempo de resolución fue de unos 23 segundos en promedio usando el warm start.
"No hay solución": ¿por qué?
Cuando el modelo es infactible, un mensaje genérico como "prueba con otros parámetros" no le sirve a quien configura. Lo útil es encontrar un subsistema irreducible infactible (IIS, por Irreducible Infeasible Subsystem): un conjunto de restricciones que no se pueden cumplir juntas, pero que se vuelve factible apenas se saca cualquiera de ellas.
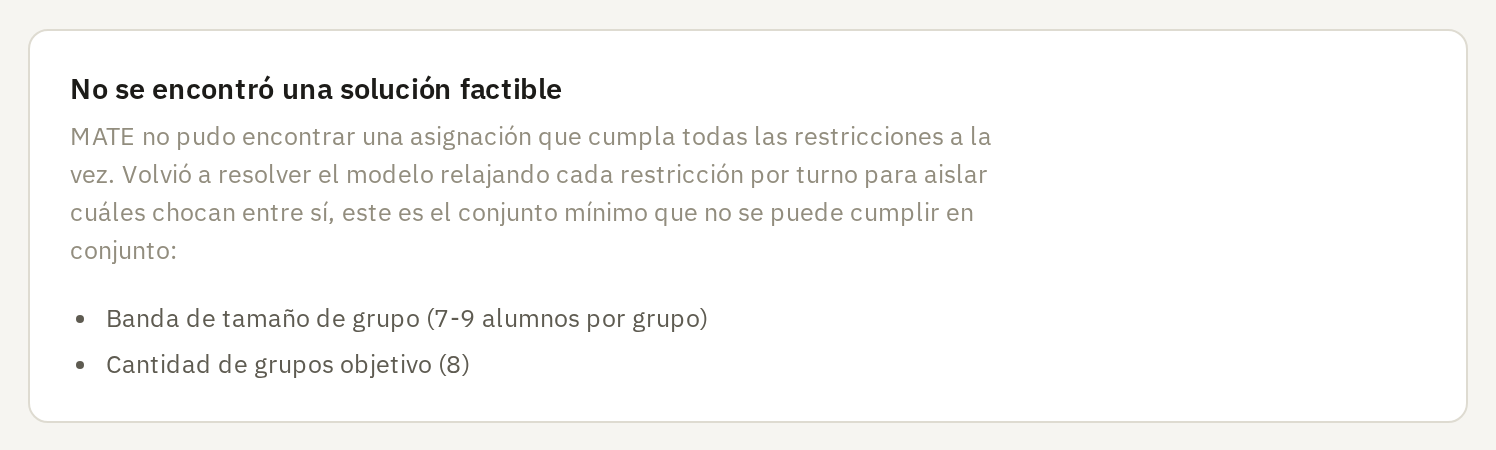
Para obtenerlo, MATE usa un filtro de borrado (deletion filter). Vuelve a resolver el modelo quitando una familia de reglas a la vez (tamaño de grupo, balance de atributos, cobertura de temas, cupos, tope de temas), con topes de tiempo cortos por prueba. Si sin esa familia el modelo se vuelve factible, la familia era necesaria y se queda. Si sigue siendo infactible, la familia sobra y se descarta. Lo que sobrevive al final es el IIS: un conjunto mínimo de reglas que, juntas, no se pueden cumplir. MATE te dice cuáles, no solo que algo falla.
Esto es lo que ve quien ejecuta MATE con 8 grupos de entre 7 y 9 alumnos para 48 estudiantes: el rango de tamaño y la cantidad de grupos son las dos reglas que no caben juntas.
Referencias: Gleeson, J. y Ryan, J. (1990). Identifying minimally infeasible subsystems of inequalities. ORSA Journal on Computing, 2(1), 61-63. Chinneck, J. W. y Dravnieks, E. W. (1991). Locating minimal infeasible constraint sets in linear programs. ORSA Journal on Computing, 3(2), 157-168.
5. Postprocesamiento
Una vez que se encuentra una solución factible, se pasa al postprocesamiento: mapear la solución del modelo a una asignación de alumnos y hacer el análisis de sensibilidad.
De tipos a alumnos reales
La solución solo dice cuántos alumnos de cada tipo van a cada grupo, no quiénes. Para cada tipo y grupo con \(y_{ig}\) mayor a cero, sacamos esa cantidad de alumnos reales de la lista del tipo. Como son intercambiables por construcción, da exactamente lo mismo cuál va a dónde. De ahí salen los grupos que muestra la pantalla de resultados, el conteo de preferencias cumplidas y el Excel descargable.
"Funciona, pero ¿qué me cuesta?"
El análisis de sensibilidad usa el mismo mecanismo pero con una solución exitosa: de las reglas que se cumplieron, ¿cuál es la que más cuesta mantener? Se mide en puntos porcentuales de alumnos con su primera opción, que es una unidad comparable entre tipos de regla. La línea base se resuelve al óptimo con exactamente los mismos ajustes que cada prueba, para que una diferencia refleje el efecto de la regla y no la variabilidad de la búsqueda. Solo corre si lo pides, nunca de forma automática.
La demo, paso a paso
Definir parámetros
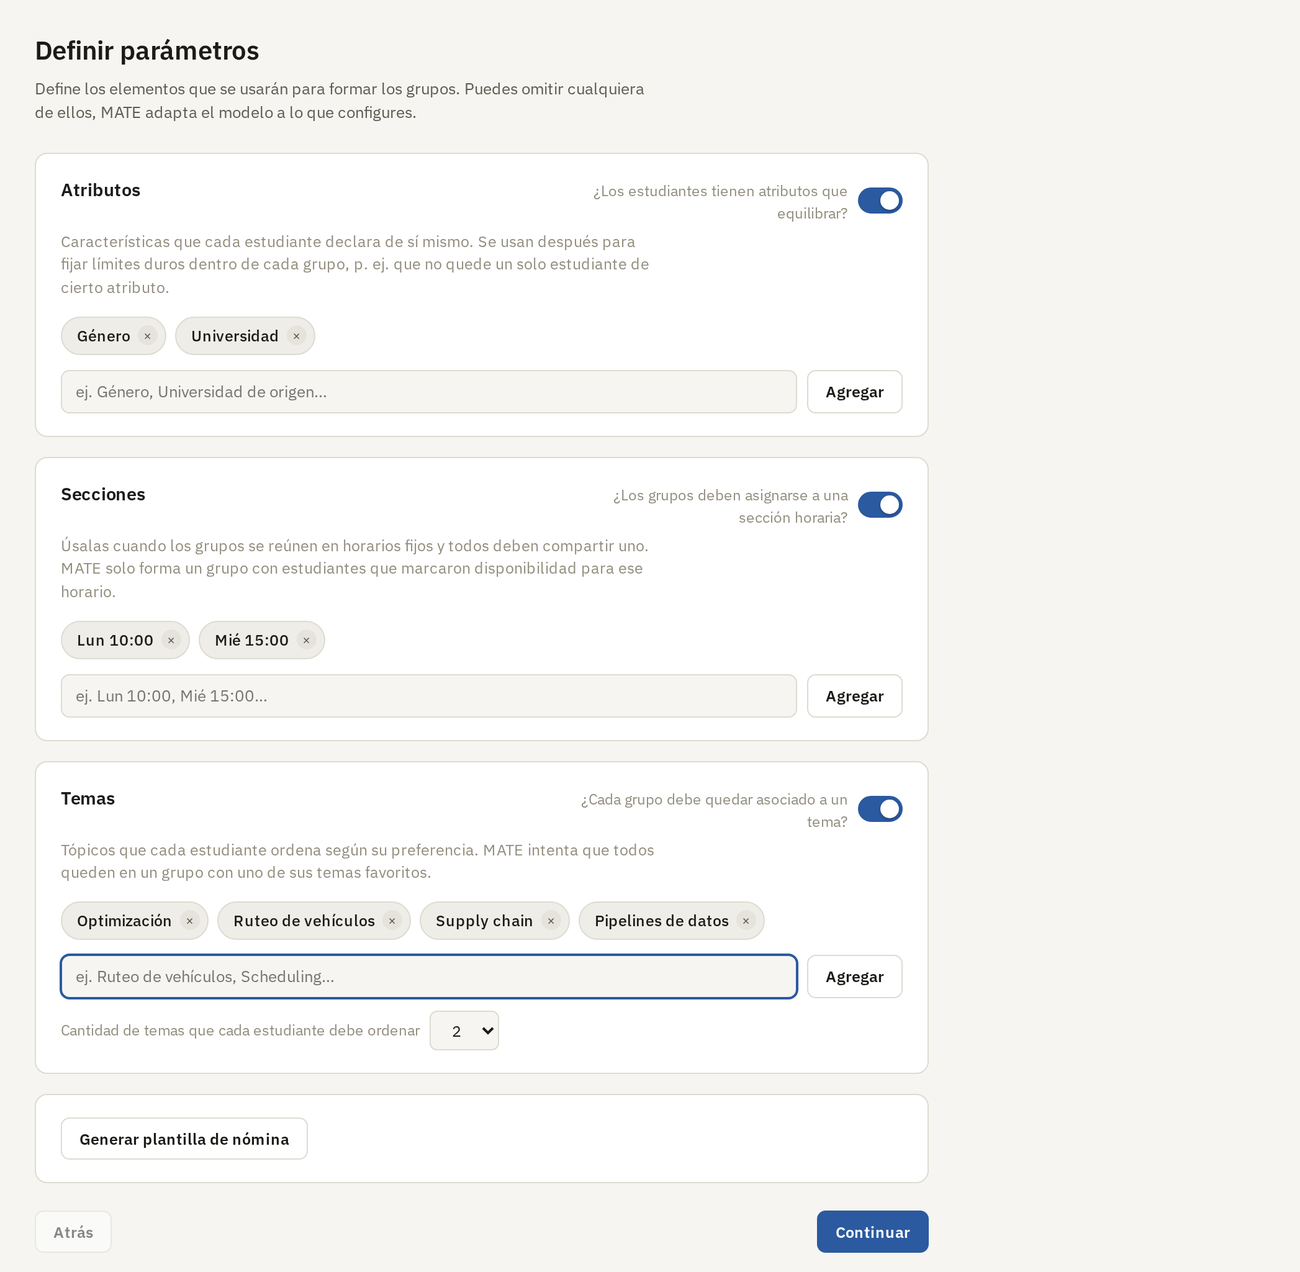
Primero le cuentas a MATE qué tiene tu curso: qué atributos quieres equilibrar (género, universidad, carrera), en qué horarios se juntan los grupos y qué temas pueden elegir los alumnos. Lo que no se use se desactiva, y el modelo se adapta a lo que se configure.
Subir la nómina
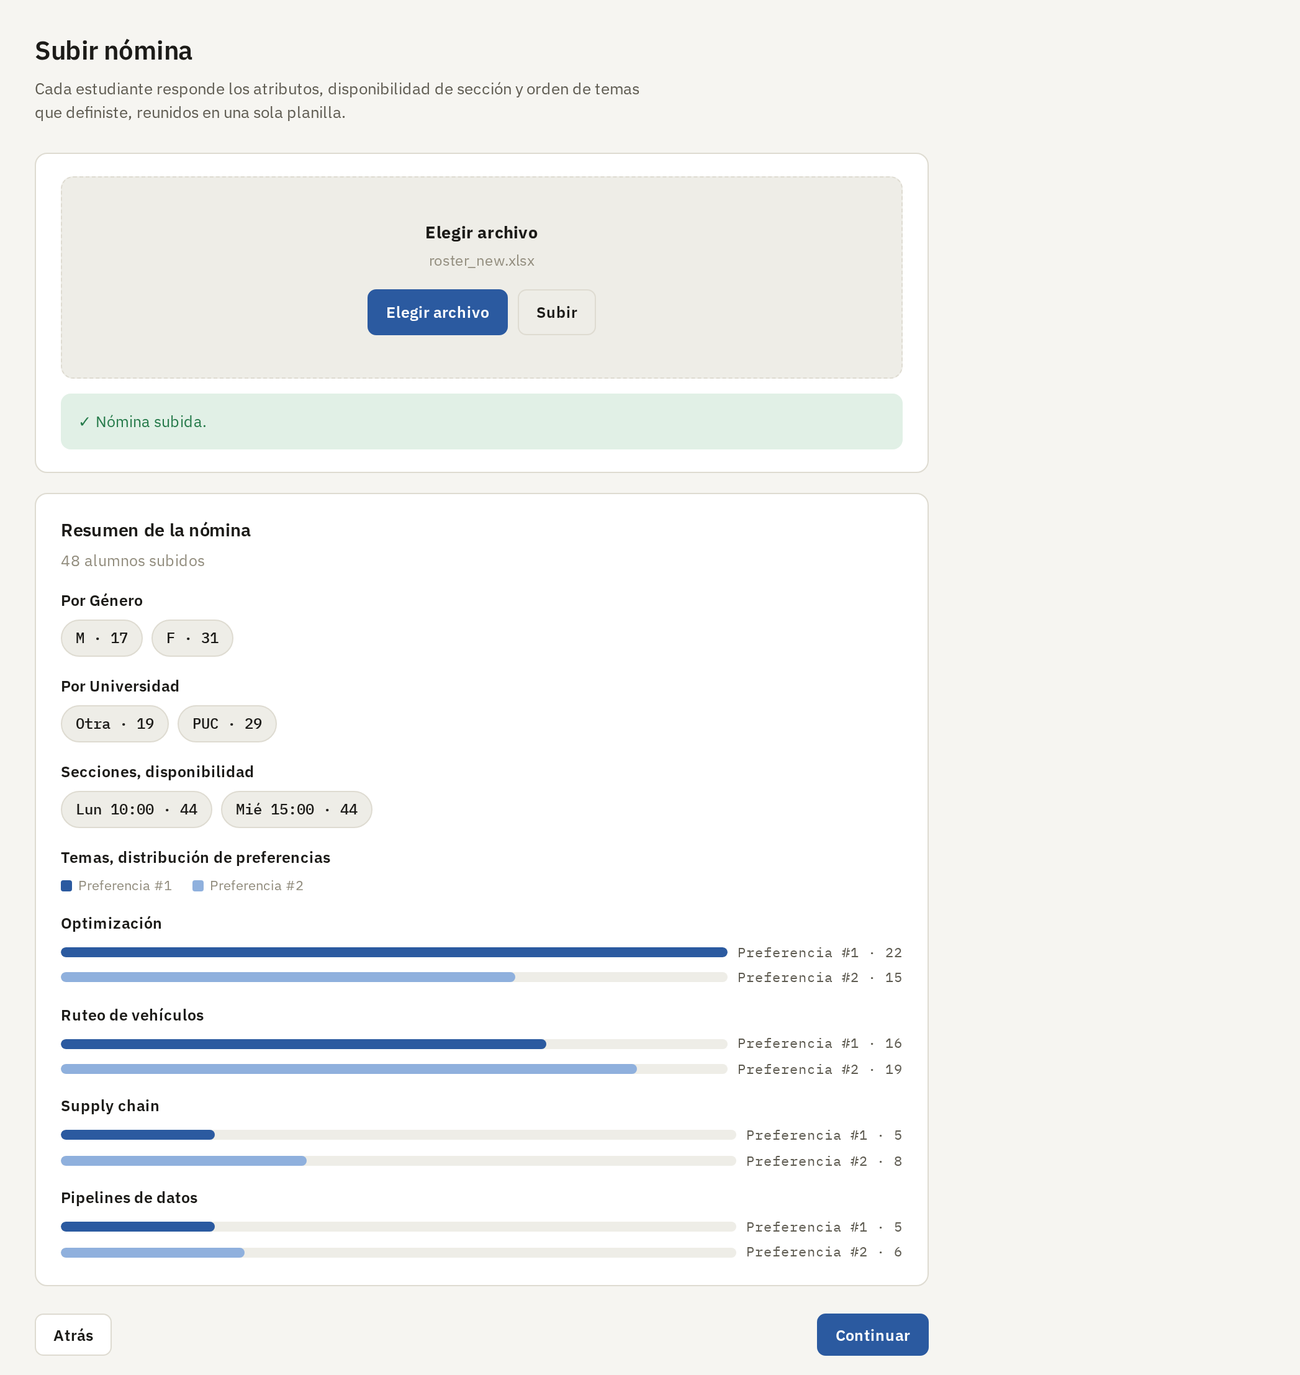
Subes una planilla de Excel (MATE te genera la plantilla). Apenas la lee te muestra un resumen: cuántos alumnos hay por atributo, cuántos tienen disponibilidad en cada horario y cuántos pidieron cada tema como primera y segunda opción. Sirve para detectar a simple vista si algo viene incorrecto antes de resolver.
Configurar y ejecutar
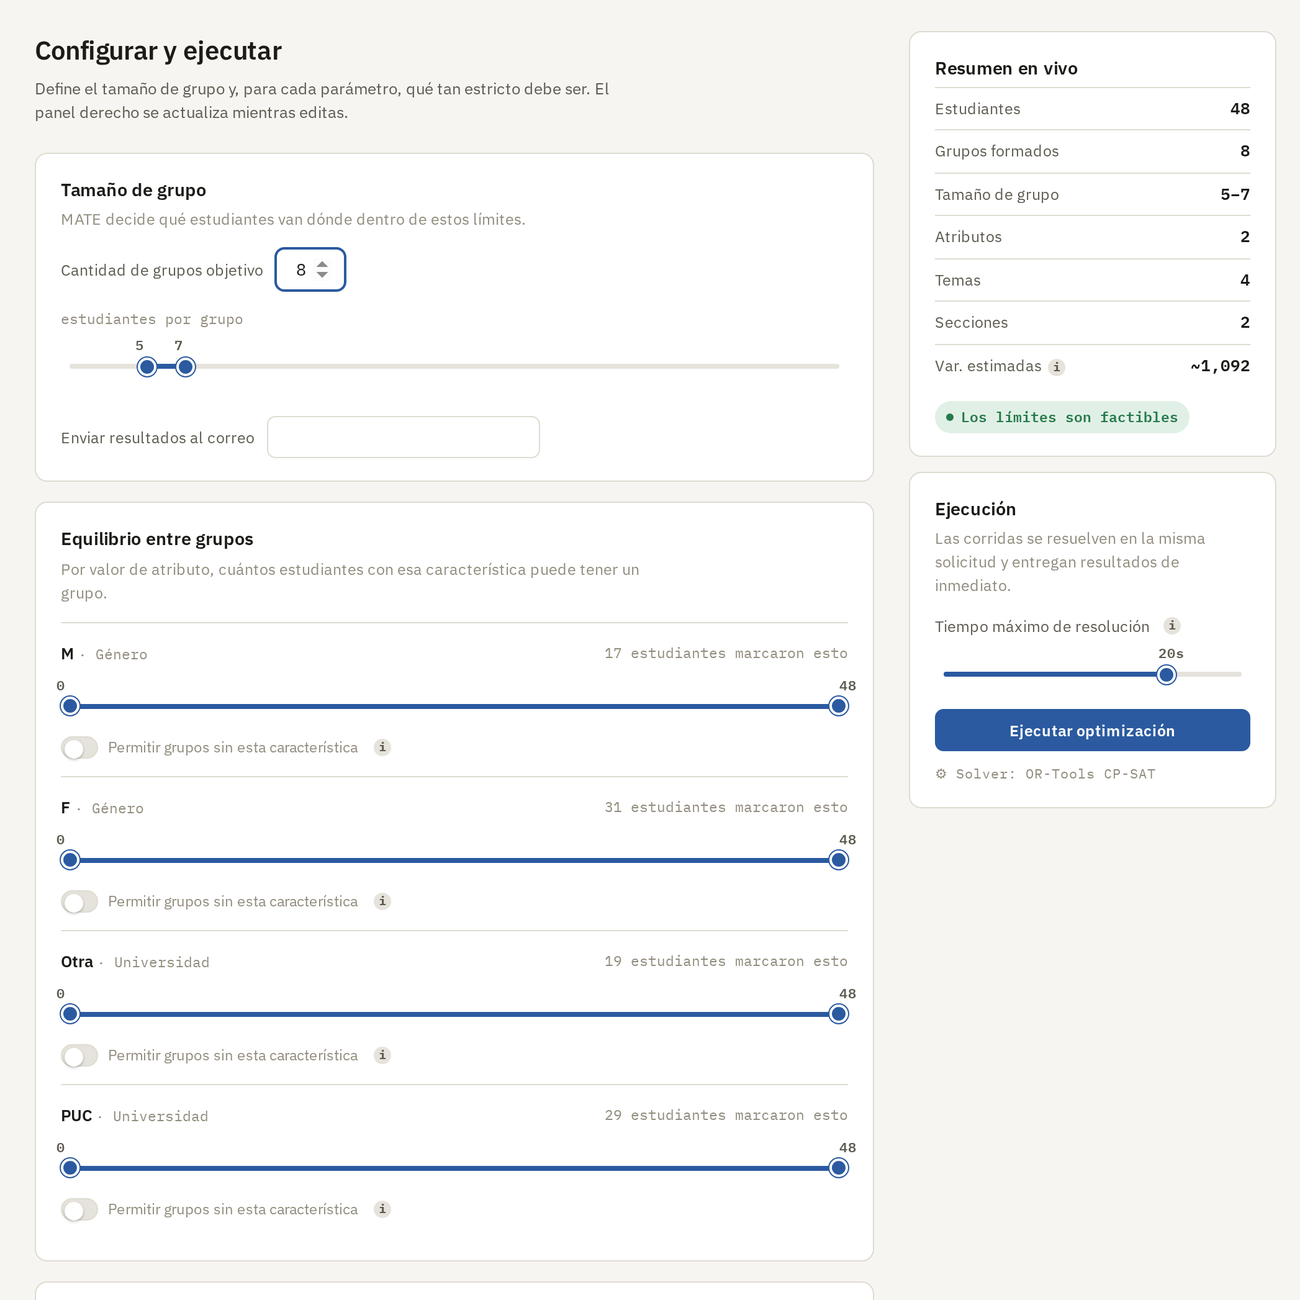
Aquí defines las reglas del problema: cuántos grupos quieres, el rango de tamaño, cuántos alumnos con cierta característica puede tener un grupo, los cupos por horario y cuántos grupos puede abrir cada tema. El panel de la derecha se actualiza en vivo, estima cuántas variables tendrá el modelo y te avisa si los límites son factibles antes de tocar el solver.
Resultados
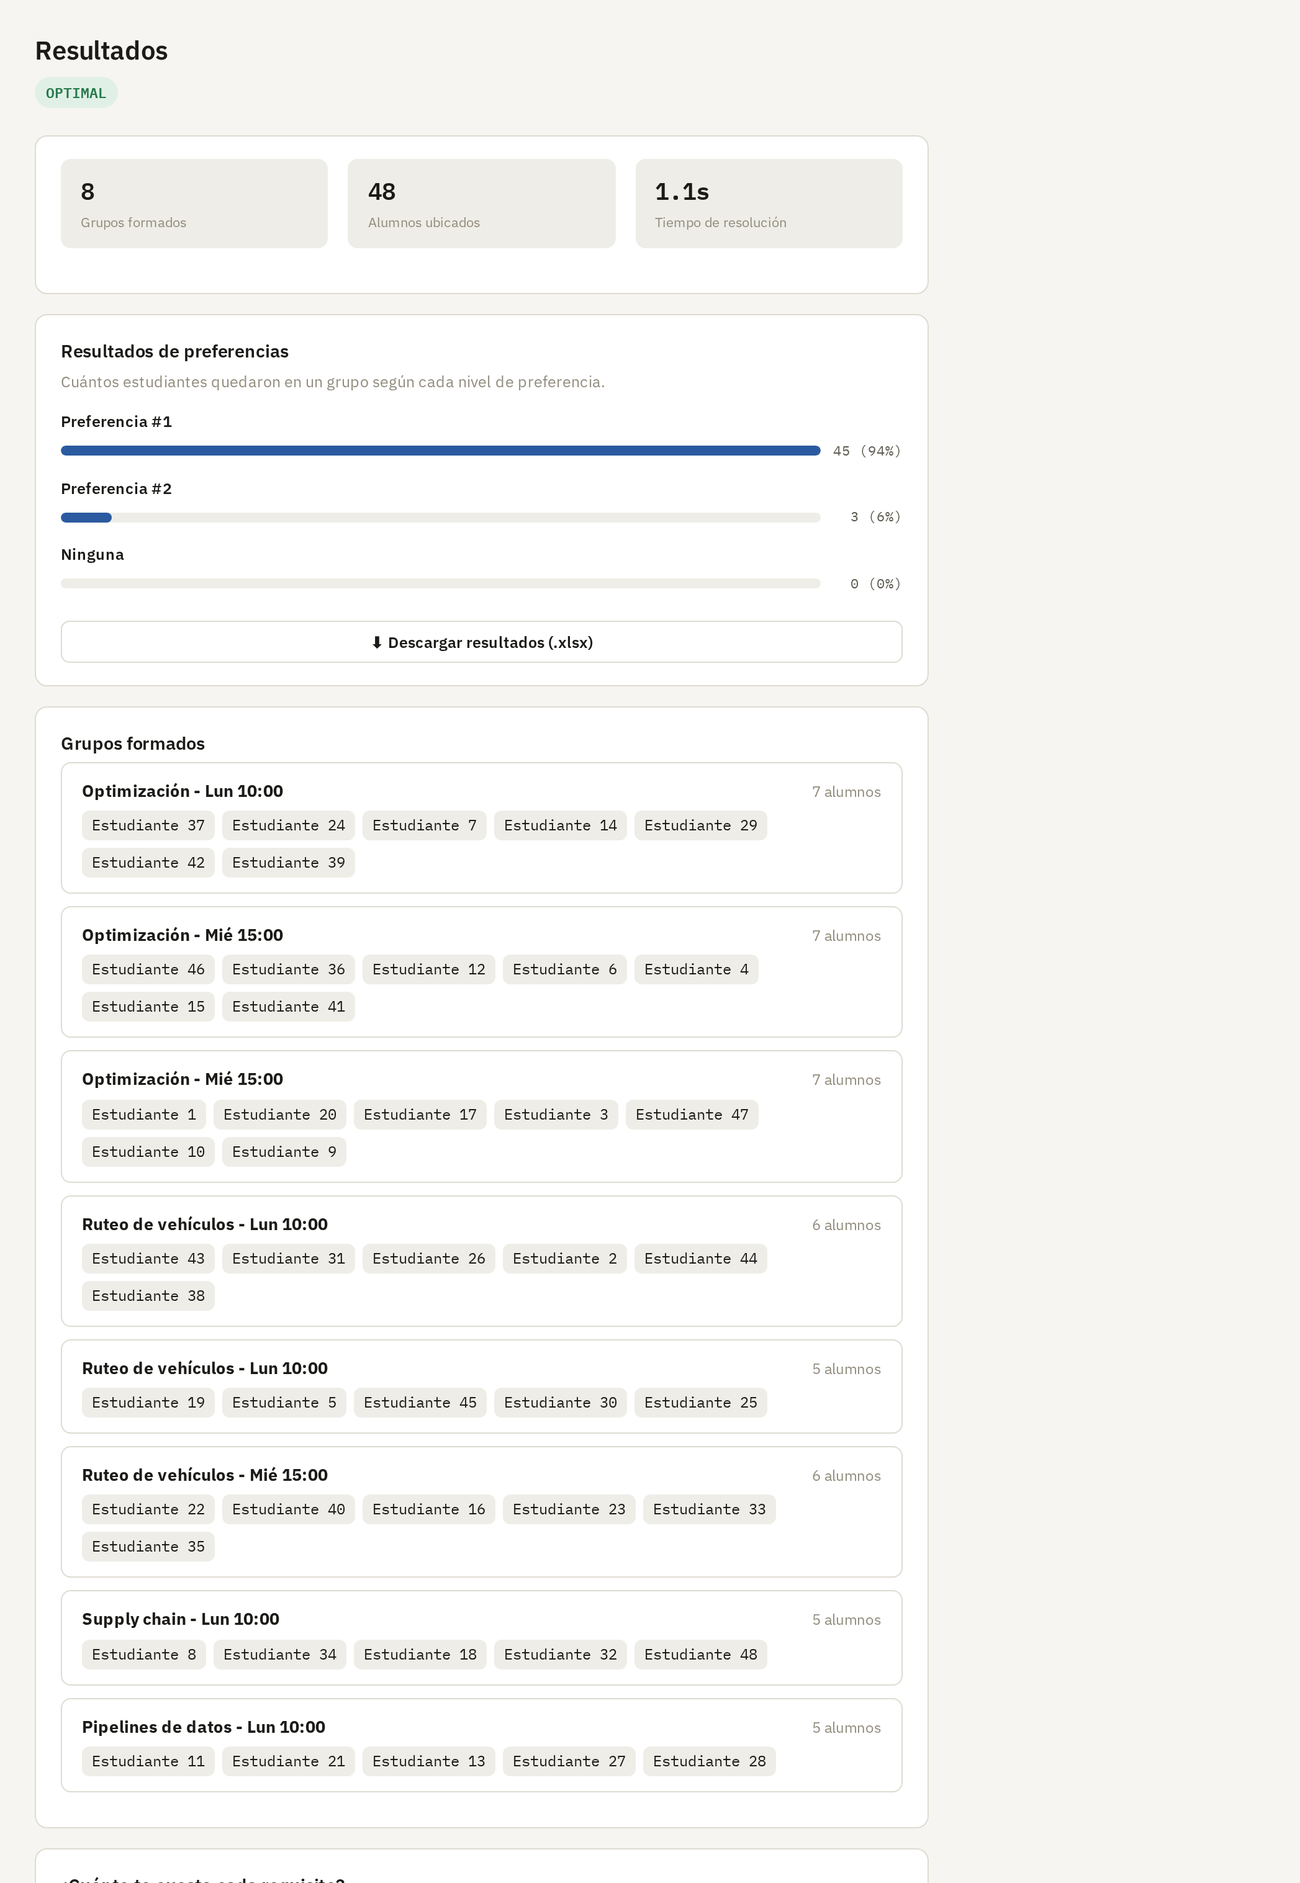
La corrida terminó en 1,1 segundos y quedó marcada como OPTIMAL: el solver demostró que no existe una repartición mejor bajo esas reglas. 45 de 48 alumnos quedaron en su primera preferencia, 3 en la segunda y nadie quedó fuera de lo que pidió. Cada grupo muestra su tema, su horario y sus integrantes, y todo se baja en Excel.
¿Cuánto me cuesta cada regla?
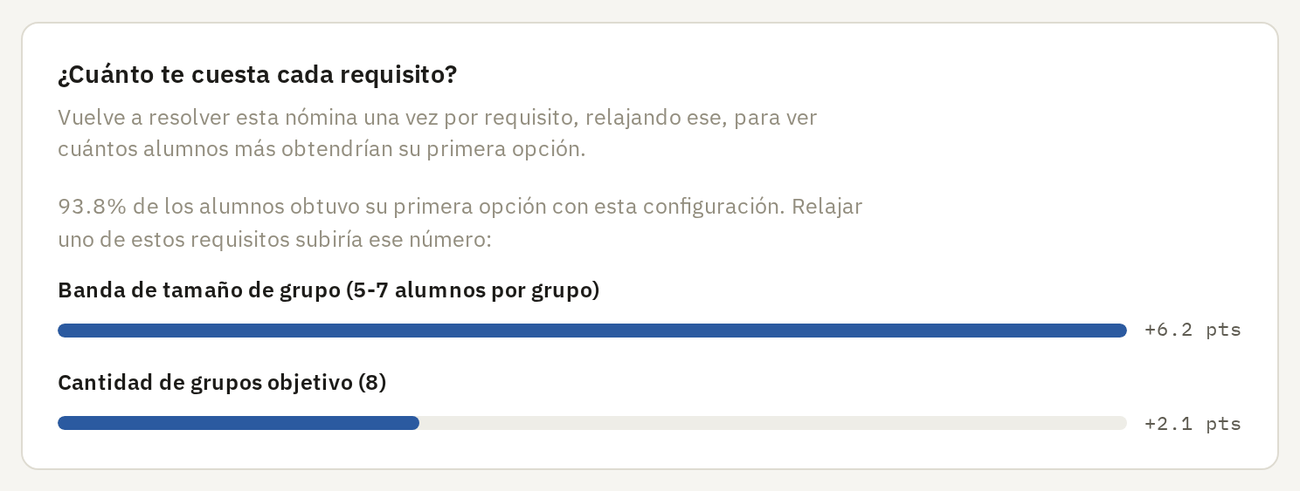
Si quieres saber qué regla tiene mayor costo, MATE vuelve a resolver relajando cada una por separado. En este ejemplo, flexibilizar el rango de tamaño subiría en 6,2 puntos los alumnos con su primera opción, y soltar la cantidad de grupos, 2,1 puntos. Las demás reglas no cuestan nada. Es información útil para decidir qué regla conviene flexibilizar, y no solo para resolver.
Resumen
Resultado
El equipo académico de Ingeniería UC dejó de armar a mano los grupos de Desafíos de la Ingeniería y Sustentabilidad. Hoy suben la nómina, miden en pantalla si sus reglas son factibles, corren el modelo y revisan la asignación. Si quieren probar otra cantidad de grupos u otra regla de balance, vuelven a resolver y comparan. Lo que antes eran varios días de trabajo manual hoy es cuestión de minutos, y se repite cada semestre.